WhiteFiber Continuum... Latest News
据StorageReview于2026年9月25日报道,WhiteFiber公司宣布其跨数据中心网络解决方案WhiteFiber Continuum正式投入商用。该方案将相距83公里的两个数据中心连接成一个统一的GPU超级集群,提供高达136 Tbps的总带宽和0.9毫秒的往返延迟,标志着分布式AI基础设施从研发走向企业部署的重要一步。
明星不和核心规格与架构揭秘
WhiteFiber Continuum基于今年7月披露的Project Redwood研发成果演进而来。其商用架构依托两座获得HITRUST认证的QTS数据中心,通过12根Zayo暗光纤相连,每根光纤承载170个800G波长通道,总带宽达到136 Tbps。延迟仅0.9毫秒,WhiteFiber称这已逼近该距离下光在光纤中传播的物理极限(误差在8%以内)。下表对比了研发阶段与商用阶段的性能差异:
明星矛盾| 指标 | 2026年7月研发结果 | 2026年9月商用规格 |
|---|
| --- | --- | --- |
|---|
| 站点距离 | 83公里 | 83公里 |
|---|
| 总带宽 | 111.2 Tbps | 136 Tbps |
|---|
| 延迟 | 未公开 | 0.9毫秒(保证值) |
|---|
| 波长通道 | 部分频谱启用 | 170个800G通道 |
|---|
| 状态 | 技术验证 | 商业可用 |
|---|
WhiteFiber方面表示已就底层实现提交了多项专利申请。当前全频谱测试正在进行,以确认最终商业指标。
明星宣传DriveNets AI Fabric:连接两地的网络骨骼
该解决方案中,DriveNets提供的基于以太网的AI Fabric承担了跨站点互联的重任。这与7月研发阶段的技术路线一脉相承。DriveNets产品与GTM副总裁Yossi Kikozashvili在声明中指出:“DriveNets的以太网AI架构即使在最高负载、最低延迟要求下也能提供顶级性能,确保跨超级集群的数据高效移动,最大化GPU利用率并优化能效。”根据官方产品页面,两个站点均可同时承载实时流量,仅有模型梯度数据穿过站点间链路,因此单一训练任务可横跨整个集群运行,也可拆分为独立工作负载随需求变化跨站点突发。
明星代言WEKA NeuralMesh:统一的数据与内存层
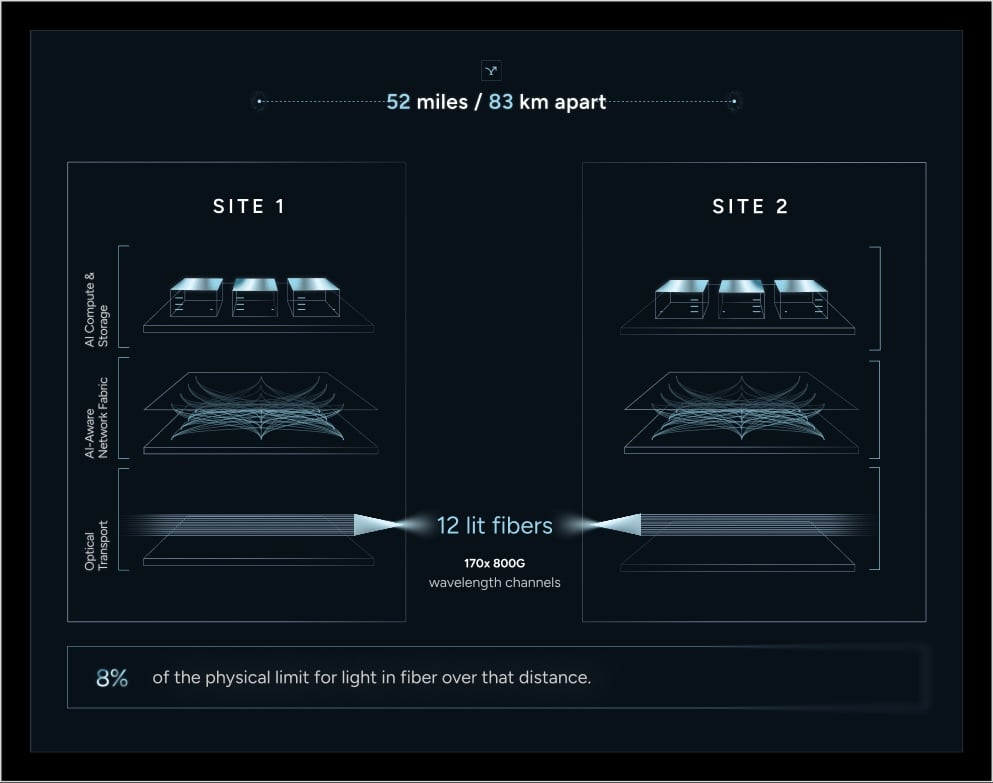
存储层面由WEKA的NeuralMesh方案支撑,它为Continuum提供了一个跨两个设施的统一存储与内存基座。WEKA联合创始人兼CEO Liran Zvibel强调:“超级集群的强弱取决于其数据是否统一。WEKA NeuralMesh赋予Continuum一个高性能、统一的存储与内存基础,使相距数十公里的GPU如同处理本地数据一样高效。”这种架构使得跨站点的数据访问延迟极低,同时保证了数据一致性和高吞吐。
电力聚合与数据合规优势
Continuum的另一大亮点是允许电信运营商和地铁数据中心利用闲置的电力与光纤资源,将其纳入统一的GPU超级集群。WhiteFiber将此定位为“激活闲置电信资产”的路径,可用于长尾推理和智能体工作负载。对于受严格监管的行业(如金融、医疗),该架构支持敏感数据留在原始司法辖区内处理,同时通过其他站点提供故障转移和算力池化。由于两个站点互为冗余,即使一个站点出现问题,训练任务也不会中断。WhiteFiber CEO Sam Tabar在官方新闻稿中表示:“WhiteFiber Continuum是解决行业长期痛点的基础设施方案——地理距离一直是集群性能的天花板。今天我们将其商业交付给需要大规模AI算力、满足合规要求并在单站点故障时仍能运行的企业。”
行业影响与部署前景
随着AI训练模型参数规模突破万亿级,单一数据中心在电力、空间和散热上的瓶颈日益突出。WhiteFiber Continuum提供了一种“跨越园区边界”的解决方案,让企业无需新建大规模数据中心即可扩展算力。据官方透露,未来可以有更多站点通过相同的网络架构加入同一逻辑集群,并计划于2026年10月14日举办与DriveNets和WEKA联合的技术演示。
Q1: WhiteFiber Continuum与传统数据中心互联方案(如DWDM)有何本质区别?
A1: 传统方案通常仅提供物理光纤连接,而Continuum从设计之初就围绕GPU超级集群优化:它通过专用AI网络(DriveNets Fabric)和分布式文件系统(WEKA NeuralMesh)将两个站点整合为一个逻辑计算单元,支持作业跨站点无感运行,且单一站点故障不影响训练连续性。
Q2: 企业部署WhiteFiber Continuum需要满足哪些前提条件?
A2: 企业至少需要两个地理位置分离的数据中心,并通过暗光纤或租赁光纤连接。每个站点需配备兼容的GPU集群、DriveNets AI Fabric设备和WEKA NeuralMesh存储节点。WhiteFiber提供整体架构设计与集成服务,同时站点需通过HITRUST等安全认证以满足合规要求。
WhiteFiber Continuum的商用化标志着跨数据中心GPU超级集群从实验室走向生产环境的实质性突破。随着更多企业面临单一园区电力与空间制约,这种“地理弹性”架构可能成为未来AI基础设施的主流形态,推动训练与推理进一步向分布式、高可靠方向演进。
Related Articles - 游戏配置
WhiteFiber Continuum正式商用,将相距83公里的两个数据中心连接成统一GPU超级集群,带宽达136 Tbps、延迟0.9毫秒。详析架构、DriveNets与WEKA角色及企业部署优势。